
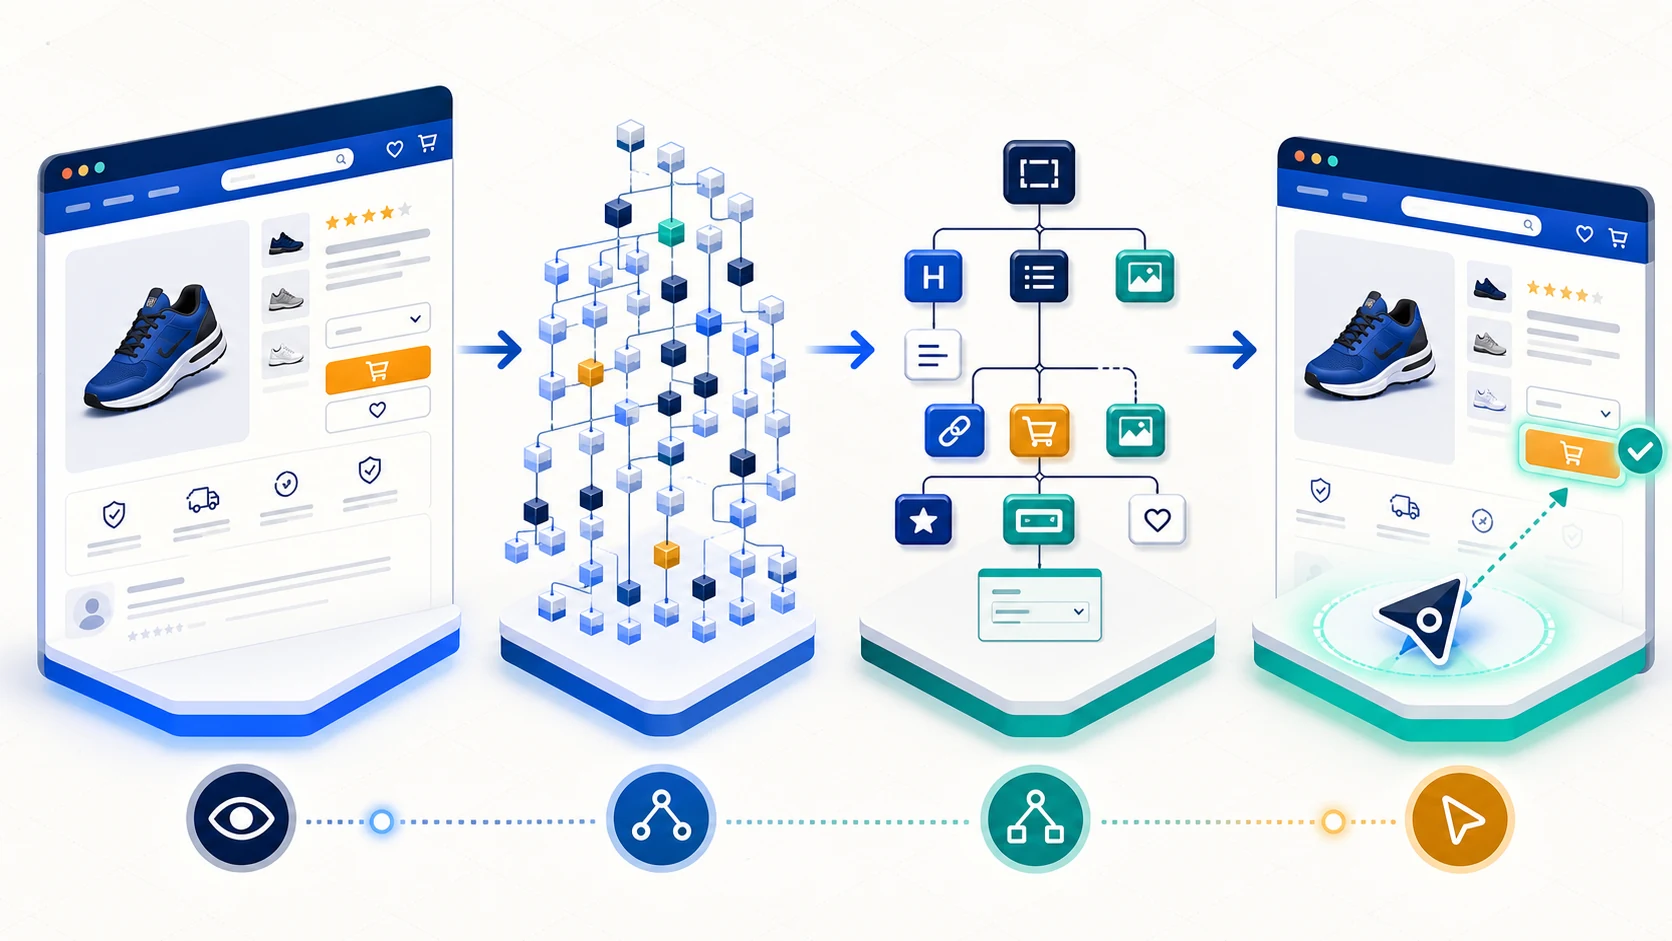
你的独立站可能看起来很正常:导航能点、筛选器能展开、询盘表单能提交、结账按钮也足够醒目。但当屏幕阅读器或AI浏览器代理访问时,它看到的可能只是大量没有名称的通用节点,根本不知道哪里是按钮、哪个字段要填、下一步该点什么。
这就是2026年技术SEO开始关注 Accessibility Tree 的原因。
不过先把边界说清楚:Accessibility Tree不是Google公开确认的独立排名因子,也不是给页面多加几个ARIA属性就能提高AI引用率的捷径。 它更像浏览器提供给辅助技术和部分AI代理的一层“机器交互界面”。这层结构越准确,代理越容易理解页面角色、控件名称、当前状态和可执行动作。
对中国出海品牌而言,真正值得投入的不是追逐一个新名词,而是检查:高价值产品页、价格页、筛选器、询盘表单和结账流程,能否同时被人、搜索引擎与浏览器代理正确使用。
Accessibility Tree是什么?
Accessibility Tree常被翻译为“无障碍树”或“可访问性树”。它是浏览器根据DOM、HTML语义、ARIA属性和控件当前状态计算出的一棵结构树,最初主要用于让屏幕阅读器等辅助技术理解网页。
它不会原样复制DOM。装饰性容器、纯布局节点和对辅助技术没有意义的内容可能被忽略;有意义的元素则会暴露出机器可读取的信息,例如:
- Role(角色): 这是标题、链接、按钮、导航、表单还是图片;
- Name(名称): 这个按钮或链接应该怎样被称呼;
- State(状态): 是否展开、选中、禁用、隐藏或按下;
- Value与关系: 输入值、描述文本、标签与控件之间的关联。
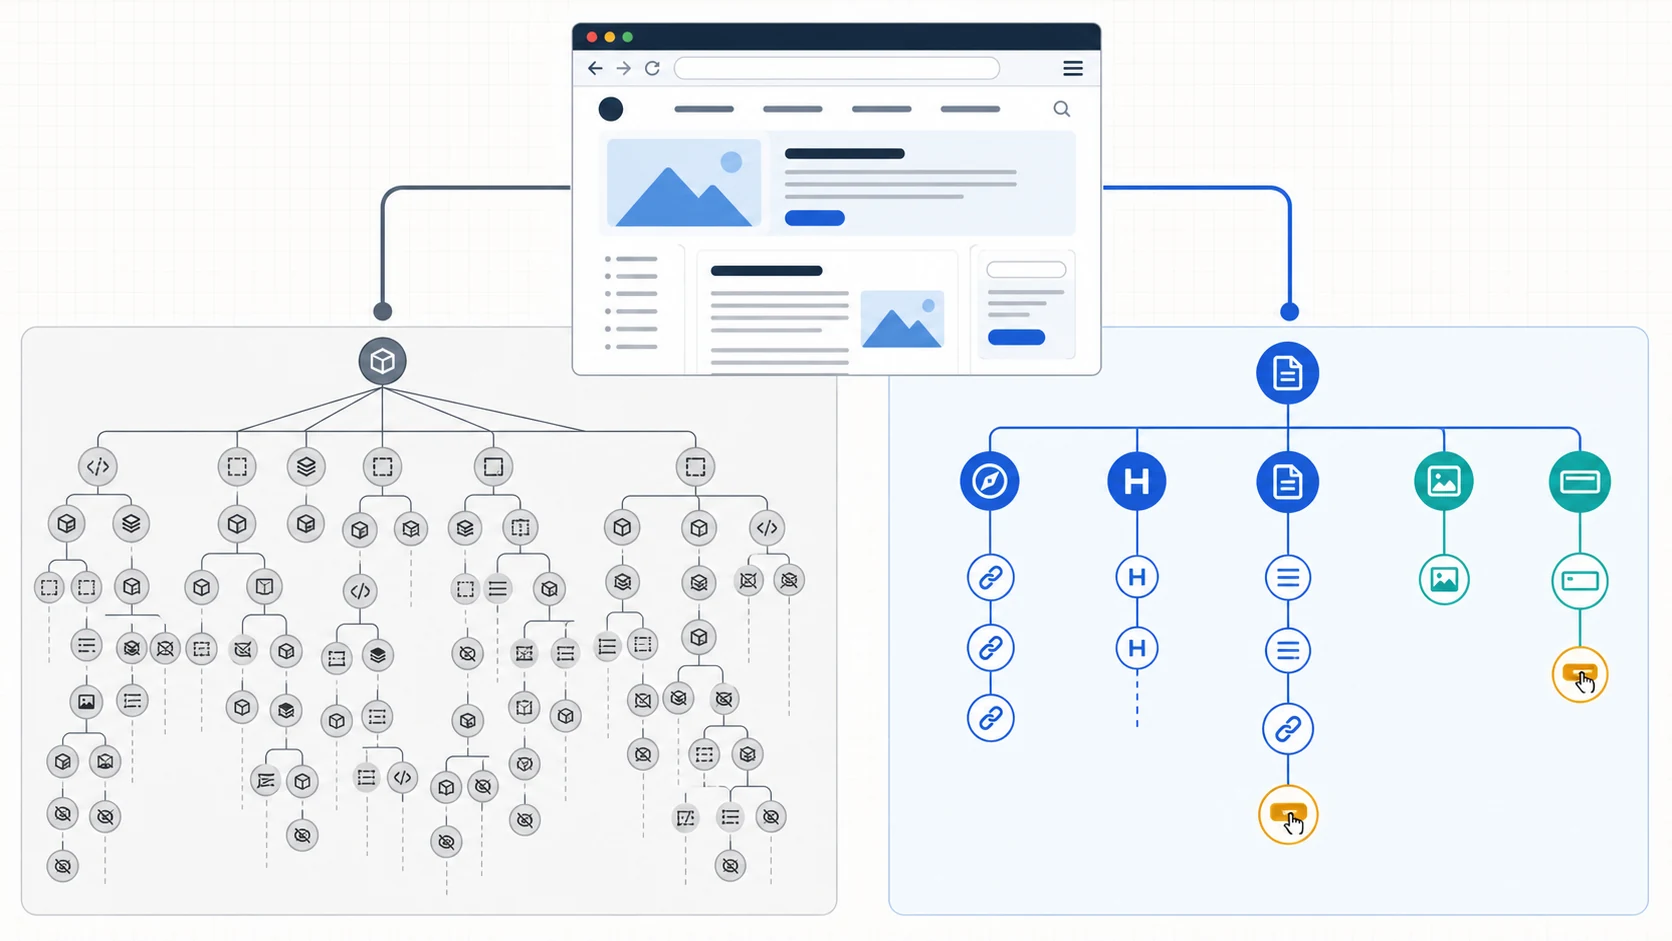
视觉界面、DOM、Accessibility Tree和结构化数据分别做什么?
| 表示层 | 主要回答的问题 | 常见SEO或代理用途 | 不能替代什么 |
|---|---|---|---|
| 视觉界面 / Screenshot | 页面看起来怎样、元素在哪里 | 多模态理解、视觉定位、版式判断 | 不能稳定表达控件语义和状态 |
| DOM | 页面由哪些节点构成、脚本渲染后出现什么 | 抓取、渲染、内容提取、链接发现 | 节点存在不等于机器知道它能做什么 |
| Accessibility Tree | 元素是什么、叫什么、处于什么状态 | 屏幕阅读器、控件识别、代理交互、可访问性审计 | 不替代抓取、索引和内容质量 |
| 结构化数据 | 页面声明了哪些实体和属性 | 富媒体搜索结果、商品和组织信息理解 | 不会修复无法点击的按钮或无标签表单 |
例如,一个视觉上像按钮的 <div>
可能存在于DOM,也能被人用鼠标点击,但在Accessibility
Tree中仍只是普通容器。代理如果只获得“generic”角色,就无法可靠判断这是购买、提交还是展开操作。
为什么AI搜索与浏览器代理开始关注这棵树?
2026年的官方资料已经给出三个明确信号。
第一,Google的生成式AI搜索优化指南说明,浏览器代理可能通过分析页面截图、检查DOM结构和解释Accessibility Tree来收集完成任务所需的数据。Google同时强调,生成式AI搜索仍建立在核心搜索索引、排名和质量系统之上,并不要求网站拥有“完美”的语义HTML。
这意味着团队应把Accessibility Tree视为新增审计面,而不是替代传统SEO。关于Google官方边界,可以结合Google AI搜索优化指南一起理解。
第二,Chrome Lighthouse已经加入实验性的Agentic Browsing类别。官方文档说明,这套审计会检查名称与标签、树结构完整性、元素是否错误隐藏,以及影响代理稳定操作的页面位移。该功能仍基于提议中的标准,要求Chrome 150或更高版本,当前展示的是通过比例和具体警告,不是新的0—100排名分数。
第三,OpenAI的开发者FAQ说明,ChatGPT Atlas会使用支持屏幕阅读器的ARIA标签与角色理解页面结构和交互元素。换句话说,正确的无障碍语义不仅帮助用户,也能让特定浏览器代理更准确地识别菜单、按钮和表单。
先立一条规则:原生HTML优先,错误ARIA比没有更危险
Accessibility Tree本来是为残障用户服务的。SEO收益只能是正确实现无障碍体验后的附加价值,不能反过来让团队为了“喂给AI”而滥用ARIA。
W3C的ARIA Authoring
Practices明确提醒:错误ARIA可能覆盖原有语义,向辅助技术提供错误信息。给一个
<div> 加上
role="button",并不会自动获得按钮应有的键盘操作、焦点管理或提交行为。
错误做法:
<div role="button" onclick="submitForm()">提交询盘</div>优先做法:
<button type="submit">提交询盘</button>第二种写法同时提供原生角色、键盘行为和清楚的可访问名称。只有在原生HTML无法表达组件行为时,才应使用ARIA补充语义,并由懂无障碍测试的人验证实际体验。
不懂代码,怎样查看自己网站的Accessibility Tree?
Chrome DevTools已经提供整页查看能力:
- 在Chrome中打开要检查的网页,按
F12打开开发者工具; - 进入
Elements面板; - 在右侧找到
Accessibility面板,必要时从更多面板中打开; - 开启
Show accessibility tree或整页Accessibility Tree视图; - 逐个检查标题、导航、链接、按钮、表单和图片节点的Role、Name与State。
DevTools适合定位单个问题与对应DOM代码。需要批量对比模板、上线前自动回归或迁移差异时,则可以使用Playwright的ARIA snapshot能力,把页面可访问结构保存为可读快照并在后续版本中比较。
10个Accessibility Tree SEO审计场景
1. 先审计带来收入和询盘的页面
不要从全站几千个URL平均用力。先从分析工具中选出10—20个高价值页面:畅销商品页、核心分类页、服务页、价格页、询盘页和结账页。
对每个页面回答五个问题:
- 主CTA是否显示为带有描述性名称的按钮或链接;
- 每个输入框是否有程序化关联的标签;
- 导航与主体内容是否有清楚的landmark;
- 价格、产品规格、交付条件与联系方式是否进入树中;
- 只看Role、Name和State,能否推断出下一步动作。
B2B网站尤其要检查价格、规格下载、预约演示和询盘入口。此前关于B2B网站AI Agent可读性的分析也说明,信息存在于页面并不等于代理能顺利提取或操作。
2. 用它发现JavaScript渲染后的第二层问题
传统JavaScript SEO审计通常只问“内容有没有渲染出来”。Accessibility Tree审计还要继续问:
内容渲染之后,有没有进入代理和辅助技术实际读取的语义层?
典型问题包括:
- 商品列表只有在客户端脚本执行后才出现;
- H1、筛选器与核心链接没有进入初始输出;
- 页面上能看到筛选按钮,但树中没有按钮角色;
- 懒加载内容出现后,名称或状态没有同步更新。
核心产品、分类内容与主要导航应尽量采用服务端渲染或预渲染。渐进增强可以晚一点加载,完成页面任务所需的主体信息不能完全依赖脆弱的客户端执行。
3. 检查AI Agent能否完成询盘或购买
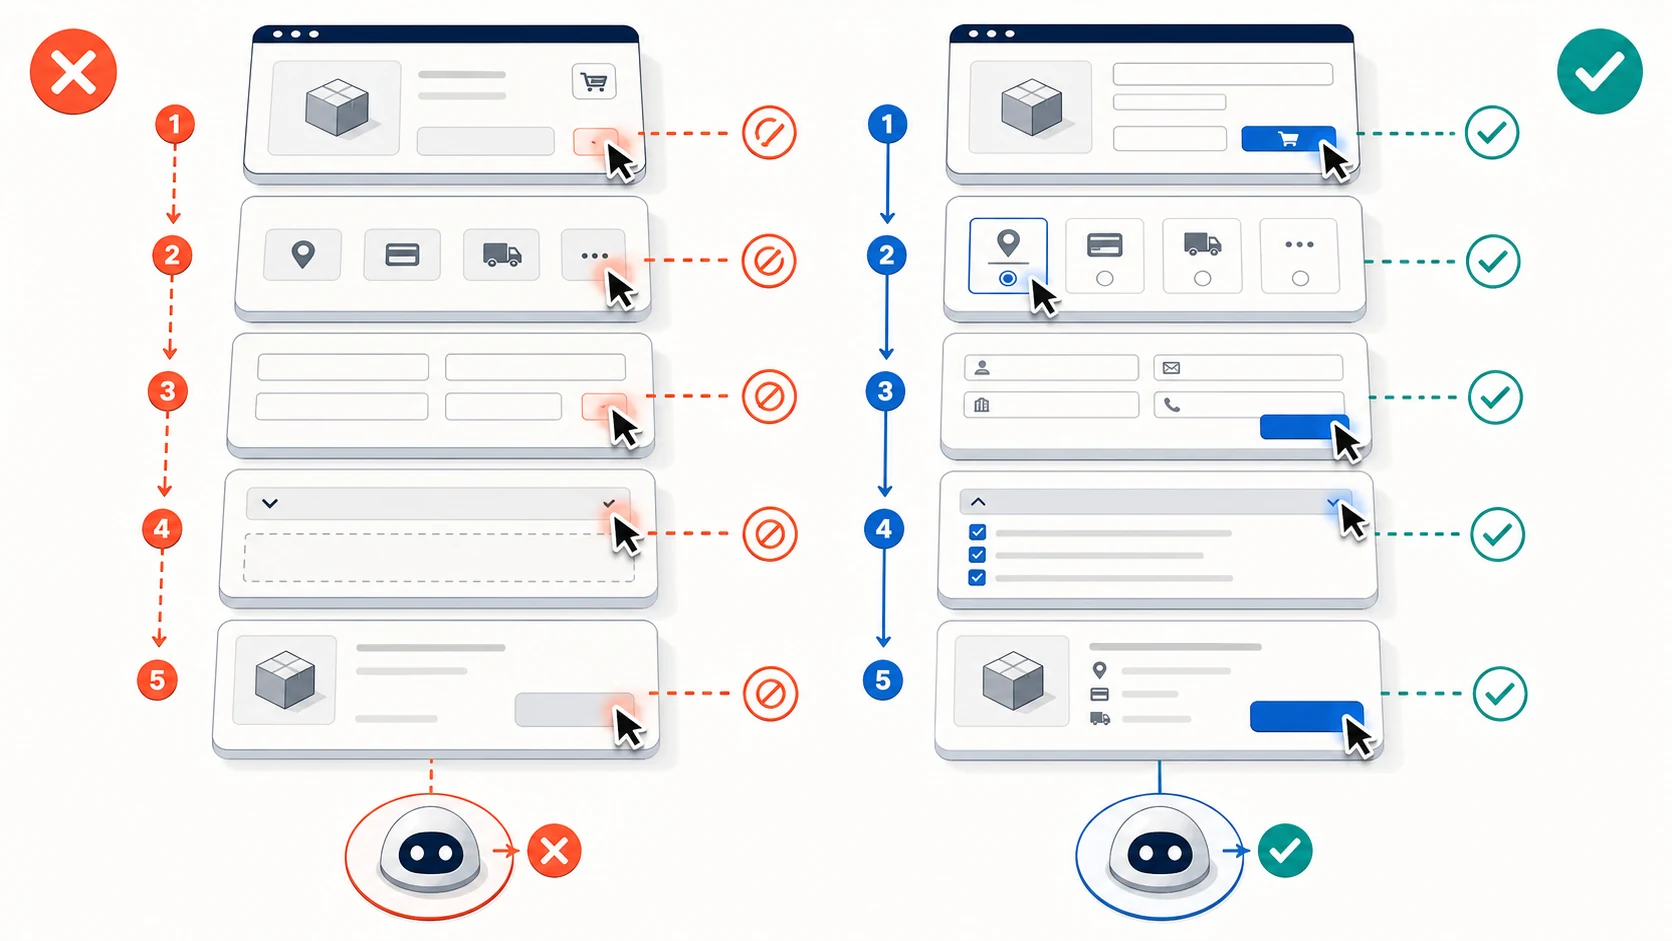
选一条真实商业路径,从头走到尾:选择商品、切换规格、打开运费说明、填写资料、提交询盘或完成结账。
每一步重点找四类故障:
- 用
<div onclick>制作的伪按钮或伪链接; - 只有图标、没有可访问名称的控件;
- 没有
<label>或关联关系的输入框; - 视觉状态变化了,但
aria-expanded、aria-selected或禁用状态没有更新。
理想结果不是“AI能猜中”,而是仅依靠角色、名称和状态就能完成整条路径。对代理式购物与B2B自动询价来说,这比单纯增加一段介绍AI的内容更接近真实能力建设。
4. 比较竞争对手机器可读性,而不是只比页面设计
选择同一类模板,对比自己与3—5个竞争对手的Accessibility Tree。建议记录:
| 对比维度 | 需要观察什么 |
|---|---|
| 有意义的交互节点 | 核心操作是否被暴露,数量是否异常膨胀 |
| 已命名与未命名控件 | 链接、按钮和输入框有多少缺少名称 |
| Landmarks | navigation、main、article、complementary是否合理 |
| 标题层级 | 页面主题与分区是否容易被分段理解 |
| 关键商业信息 | 价格、规格、库存、配送、CTA是否可读取 |
“节点更多”不等于更好。目标是用更少的歧义表达完整任务,而不是把DOM复杂度换成另一棵复杂树。
5. 验证标题与Landmark的最终输出
爬虫导出的H1/H2只能说明HTML里写了什么,Accessibility Tree显示浏览器最终向辅助技术暴露了什么。
重点检查:
- 视觉标题是否只是加粗的
<div>; - 是否存在多个互相竞争的页面主标题;
- 标题层级是否能反映真实内容从属关系;
- 主体内容是否位于
main或article等合理区域; - 导航、侧边栏和正文能否被清楚分开。
不要为了迎合检查工具机械追求某种节点数量。结构的目标是让用户与机器都能理解页面边界和阅读顺序。
6. 检查内链的Accessible Name有没有被破坏
传统内链审计看到的是可见锚文本;Accessibility Tree显示的是屏幕阅读器和代理实际收到的链接名称。
三类问题最常见:
- 大量重复的“了解更多”“点击这里”;
- 箭头、Logo和社交图标链接没有名称;
- 错误的
aria-label覆盖了原本清楚的可见锚文本。
例如,可见文字是“比较企业版价格方案”,但代码额外设置
aria-label="链接",最终暴露的名称可能只剩“链接”。正确做法是保留清楚的可见锚文本,只在图标链接等确实没有文字的情况下补充准确名称。
7. 盘点图片究竟提供了信息还是噪声
筛选Accessibility
Tree中的image角色,可以直接看到每张图对机器暴露的名称,也就是通常来自
alt 的内容。
把问题分成三类:
- 有意义图片没有名称: 产品细节、流程图或数据图使用空alt;
- 装饰图制造噪声: 纯背景和分隔元素被朗读;
- 名称没有信息: 使用“图片”“chart”“photo123”等占位描述。
有意义图片应提供能替代其信息的alt,并在复杂图表附近放置解释文本或
<figcaption>;纯装饰图片使用
alt="",让它们退出Accessibility
Tree。alt不是堆关键词的位置,也不能替代正文对关键数据的说明。
8. 把ARIA快照加入持续集成
一次审计只能说明今天没问题。组件升级、主题更新和前端重构都可能在下一次发布中移除按钮名称、landmark或表单标签。
Playwright的 toMatchAriaSnapshot()
可以把页面的可访问结构保存为版本化基线。以后每次构建重新采集并比较:
- 按钮名称从“提交询盘”变成空值,测试失败;
mainlandmark消失,测试失败;- H1被组件重构成普通文本,测试失败;
- 合理改版产生预期变化,则由人工审核差异后更新基线。
这类测试适合首页、商品页、分类页、价格页、询盘和结账等少数核心模板,不建议不加筛选地给全站每个URL建立快照。
9. 在改版和迁移时比较新旧树
网站迁移可以保住URL、Title、canonical和重定向,却同时破坏用户与代理看到的结构。例如新组件库把所有CTA换成可点击的
<div>,从传统迁移表面看没有问题,但可操作性已经下降。
上线前后分别保存核心模板快照,并把差异分为:
- 上线阻断: 核心按钮或链接没有名称、表单无法操作、重要landmark消失;
- 高优先复核: 标题关系改变、内容顺序异常、交互状态不更新;
- 预期变化: 新增模块或经过批准的名称调整。
Accessibility Tree diff应与重定向、canonical、索引、结构化数据和页面性能检查并列,而不是替代它们。
10. 用SEO与商业价值排整改顺序
Accessibility问题仍应保留WCAG严重度视角,因为它首先影响真实用户;但为了让开发资源优先投入高影响页面,还可以增加商业维度。
给每个模板记录:
- GSC自然点击与重要查询;
- 询盘、收入或转化价值;
- AI答案中的品牌或URL引用情况;
- 问题类型与受影响的任务;
- 修复成本和复测责任人。
价格页的无名称提交按钮,通常比旧博客中的装饰图alt问题更应优先修复。但低商业价值页面的严重无障碍障碍不能因此被永久忽略;商业优先级与合规、用户影响应并行管理。
一套适合独立站的30天审计流程
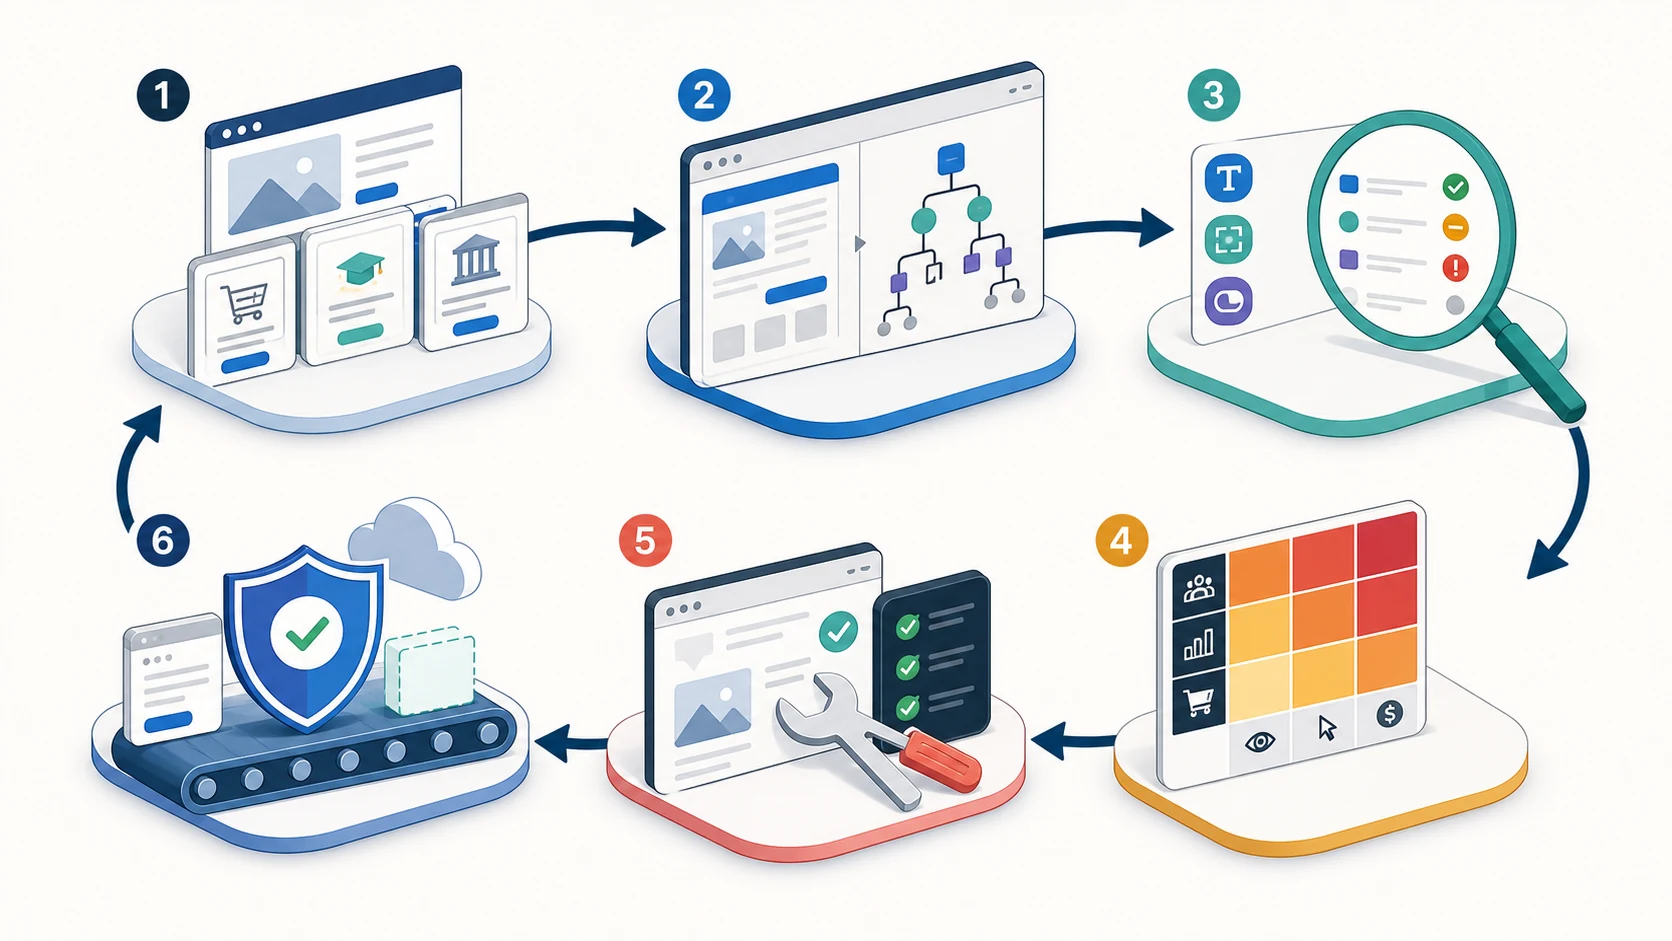
第1周:建立页面与任务清单
选出10—20个高价值模板,记录每页最重要的用户任务,例如查看规格、筛选商品、下载资料、询价、加购或付款。不要一开始扫描全站。
第2周:采集树并分类问题
用Chrome DevTools人工检查关键节点;技术团队可用Playwright保存ARIA快照。按角色、名称、状态、landmark、标题、图片与JS渲染七类问题归档。
第3周:原生语义优先修复
先把伪按钮、伪链接和无标签输入框替换为原生HTML,再处理确实需要ARIA的复合组件。每项修改都同时进行键盘操作、屏幕阅读器或专业无障碍测试,不能只看自动工具是否变绿。
第4周:复测并建立防回归机制
复测核心任务,保存合格快照,并在主题更新、组件升级、迁移和大促页面发布前加入差异检查。最终看的是任务成功率和结构稳定性,而不是追求一个孤立分数。
什么时候应该由专业无障碍人员介入?
出现以下情况时,不要只靠SEO或开发团队自行判断:
- 医疗、金融、教育、政府等受监管行业;
- 服务大量残障用户或面向有明确无障碍要求的市场;
- 使用复杂自定义组件、键盘交互、焦点管理或动态状态;
- 已收到用户投诉、法律通知或采购方的无障碍要求;
- 自动测试与真实屏幕阅读器体验存在冲突。
自动工具能发现缺失属性,却不能完整判断一个人能否顺利完成任务。Accessibility Tree是诊断入口,不是无障碍合规证明。
Accessibility Tree会直接提高Google排名吗?
目前没有Google官方资料把Accessibility Tree列为独立排名因子。Google反而提醒:生成式AI搜索仍依赖原有搜索索引、排名与质量系统,语义HTML不需要为了机器追求“完美”。
但这不代表它没有SEO价值。正确语义往往同时改善:
- 可抓取的真实链接;
- 清楚的标题与内容分区;
- 可理解的图片描述;
- 可操作的表单与购买路径;
- AI浏览器代理的任务成功率;
- 用户体验和网站质量治理。
因此,Accessibility Tree SEO的正确定位是:用辅助技术的机器视角,发现传统抓取和视觉检查遗漏的结构与交互问题。
对于包含复杂筛选、定制询盘、多语言表单和自动化组件的出海网站,Google SEO/GEO优化不应只检查关键词、外链和结构化数据,还要把渲染结果、Accessibility Tree与真实任务完成放进同一套技术审计。
FAQ
Accessibility Tree和DOM是同一个东西吗?
不是。DOM记录页面节点结构;Accessibility Tree由浏览器根据DOM、原生语义、ARIA和当前状态计算,通常只保留对辅助技术有意义的节点和属性。
给页面多加ARIA标签就能让AI更懂吗?
不能这样理解。原生HTML应优先。错误ARIA可能覆盖正确语义、误导屏幕阅读器和代理,甚至让页面比修改前更难使用。
为什么视觉上能点击的按钮,在树里可能不是按钮?
因为开发者可能用带点击事件的普通 <div>
模拟按钮。它有视觉样式和鼠标行为,却没有原生按钮角色、键盘行为与可访问名称。
Accessibility Tree能替代JavaScript SEO审计吗?
不能。它是渲染审计后的新增检查层。团队仍要验证抓取、初始HTML、客户端渲染、链接发现、canonical、索引和性能。
Lighthouse Agentic Browsing分数会影响排名吗?
官方没有这样说明。该类别目前仍是实验性审计,展示通过比例与具体问题,不是Google搜索排名分数。
只用自动工具就能完成无障碍合规吗?
不能。自动工具适合发现结构化错误,真实键盘导航、屏幕阅读器体验、焦点管理和任务完成仍需要人工与专业测试。
哪些页面最应该先查?
优先检查收入、询盘和用户任务最集中的页面:产品页、分类筛选、服务页、价格页、询盘表单、注册和结账流程。
参考资料
- Search Engine Land:10 SEO use cases for auditing your accessibility tree for AI search ,2026年8月5日。
- Google Search Central:Optimizing for Generative AI Features on Google Search ,访问于2026年8月7日。
- Chrome for Developers:Lighthouse agentic browsing scoring ,访问于2026年8月7日。
- Chrome for Developers:Accessibility features reference ,访问于2026年8月7日。
- OpenAI Help Center:Publishers and Developers FAQ ,访问于2026年8月7日。
- Playwright:ARIA snapshot testing ,访问于2026年8月7日。
- W3C WAI:No ARIA is better than Bad ARIA ,访问于2026年8月7日。
- web.dev:The Accessibility Tree ,访问于2026年8月7日。
本文基于截至2026年8月7日的Google、Chrome、OpenAI、Playwright与W3C公开资料整理。Agentic Browsing、WebMCP和浏览器代理能力仍在快速变化,实际审计应以最新官方文档、目标浏览器及真实辅助技术测试结果为准。